GPT-4V是什么?怎么使用?关于OpenAI 最新GPT-4 Vision多模态的一切
产品名与查阅日期(2026-10-16)
「GPT-4V / GPT-4 Vision」是历史产品称呼。 现行 ChatGPT 中,图像理解对应官方所说的 image inputs(图像输入):在对话中上传图片并提问。相关能力随当前模型与工具提供,不再绑定「必须选 GPT-4 / GPT-4V」。
官方依据(请以原文为准):
- ChatGPT Image Inputs FAQ
- Uploading files and audio to ChatGPT
- ChatGPT capabilities overview
- 旧型号退役背景:Retiring GPT-4o and other ChatGPT models
下文保留「GPT-4V」检索词与部分历史说明,但操作与可用性请以现行 Help / 界面为准。
GPT-4V是什么?
历史上,GPT-4V 指带视觉(Vision)能力的 GPT-4,可分析用户上传的图像。今天更准确的说法是:ChatGPT 支持 image inputs——所有当前 ChatGPT 模型均可接受图像输入(见 8400551,查阅日期:2026-10-16);ChatGPT 中的 GPT-4 / GPT-4o 等旧文本型号已按官方说明退役或不再作为主路径(见 20001051)。
如何使用现行的图像理解(原「GPT-4V 多模态」)?
据 8400551 与 8555545(查阅日期:2026-10-16):
- 在输入框点击 +,选择添加照片/文件;也可拖拽或粘贴图片。
- 说明你想做什么(识别物体、读图中文字、解释图表等)。
- 套餐:图像输入在 Free 与付费计划均可使用(受计划限额与账号设置约束);不是「仅 Plus / 仅 GPT-4V」才能用。
- 格式与大小:常见为 PNG / JPEG / 非动画 GIF;单张约 20 MB(详见 Help)。
若上传失败,见站内:上传用户数据失败。账号开通与购买说明可参考:账号购买教程。
GPT-4V是怎么训练出来的(历史资料)
OpenAI 曾发布技术说明(GPT-4V System Card 等)介绍早期视觉模型。论文/卡片地址示例:GPT-4V技术原理。
据当时公开材料:GPT-4V 相关训练较早完成,并曾向早期访问用户开放。这些历史训练叙事不等于现行 ChatGPT 图像输入仍叫 GPT-4V,也不等于必须购买「GPT-4V 专用」套餐。
以下「能力 / 局限」列表多来自早期公开材料与社区整理,可能已过时;现行限制以 8400551 为准(例如:不适合解读专业医学影像、非拉丁文字图像较弱、旋转/空间定位/计数等可能不准等)。
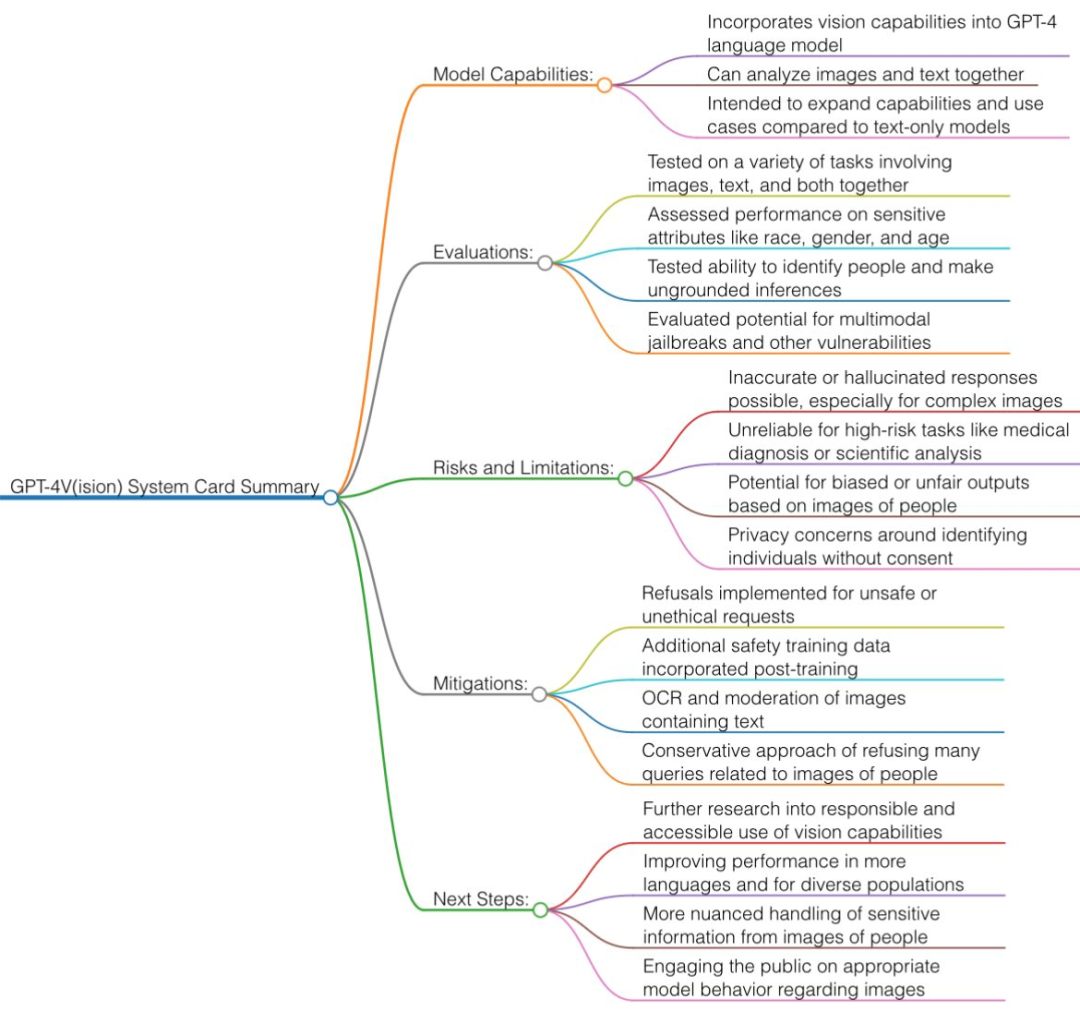
GPT-4V的技术原理(历史背景)
多模态模型通常将文本与图像映射到可共同推理的表征空间。早期公开讨论常提到 CLIP 一类视觉—语言桥接思路。具体现行架构以 OpenAI 当前文档为准,本页不作实现承诺。
ChatGPT 图像输入:现行能力摘要(对照官方)
据 9260256 与 8400551(查阅日期:2026-10-16),你可以:
- 询问图中有什么、提取可见文字/内容、协助解读图表或截图;
- 在后续轮次继续追加图片;
- 需要时先在本地标注后再上传,以引导关注区域。
早期材料中曾列出的方向(仅作历史参考)
- 物体检测、OCR、复杂图表等——实际效果因图而异,且可能出错
- 人脸属性、地理定位、验证码等——现行产品对敏感识别常有限制或拒绝;勿依赖模型做身份核验或绕过验证码
- 医学等严肃场景——官方明确不适合解读 CT 等专业医学影像,也不应当作医疗建议(8400551)
现行官方局限(摘要)
据 8400551(查阅日期:2026-10-16),需注意例如:医学影像不适用;非拉丁文字较弱;大段小字需放大;旋转图像易误读;图表线型/颜色变化可能混淆;精确空间定位与计数可能不准;描述可能错误;全景/鱼眼较弱;不处理原始文件名与元数据等。完整列表见 Help 原文。
另请记得:模型可能误判——见站内 也可能犯错。
相关阅读
- 模型可能误判图像或事实时,请对照:ChatGPT「也可能会犯错,请核查重要信息」说明
- 附件 / 图片上传失败时,见:ChatGPT「上传用户数据失败」排查摘要